
Как проверить, что нейросеть работает правильно: из 18 объяснений правдой оказались 4
Исследование9 мин 8 Обновлено 29 сентября
TL;DR
- Нейросеть объясняет свой выбор убедительно и при этом делает другое: из восемнадцати прогонов заявленное совпало с фактом в четырёх.
- Рейтинг моделей, составленный по их собственным объяснениям, перевернулся после первой же сверки с картинками.
- Дважды на завышенных обещаниях была поймана не модель, а моя проверка: число, которое она выдавала, не было измерением.
- Сотни прогонов на меняющейся программе доказывают меньше, чем тридцать на одной замороженной версии с размеченным эталоном.
- Три способа, меряющие одно и то же, дают один голос, а выглядят как три подтверждения. Для нескольких нейросетей ловушка ровно та же.
Нейросеть подробно описала коробку, на которую поставила код маркировки: ровная лицевая сторона, свободное место справа. Уверенность в ответе – 0,96 из 1. Коробки на фотографии не было вообще.
Это не единичный сбой. Из восемнадцати объяснений, которые я проверила по факту, с реальностью совпали четыре.
Почему нельзя верить объяснениям нейросети
Представьте, что вы наняли человека наклеить этикетки на партию товара. Он отчитался: наклеил ровно, на гладкое место, шов обошёл. Вы заплатили и не стали проверять. А через неделю выяснилось, что половина этикеток сидит ровно на шве. Отчёт был складный, только его никто не сверял с коробками.
С нейросетью происходит то же самое, и это сбивает с толку сильнее, чем прямая ошибка. Модель не просто называет место для кода – она объясняет свой выбор: выбрала ровную лицевую поверхность, обошла шов, на пористую ткань клеить нельзя. Читаешь и веришь.
Ошибки при этом бывают двух разных видов, и путать их не стоит.
Первый – выдумка. Та самая коробка, которой не было: модель описала предмет, которого нет на фотографии, и заодно назвала нулевую кривизну у явного цилиндра. Это называют галлюцинацией – модель уверенно сообщает то, чего в данных нет.
Второй – расхождение слов и дела. Модель перечислила всё, что обошла: тканевую сетку колонки, амбушюры, подвижную мембрану, стыки деталей. И написала прямо: код размещён на гладкой пластиковой поверхности чашки наушников, потому что пористая сетка не обеспечит крепления.
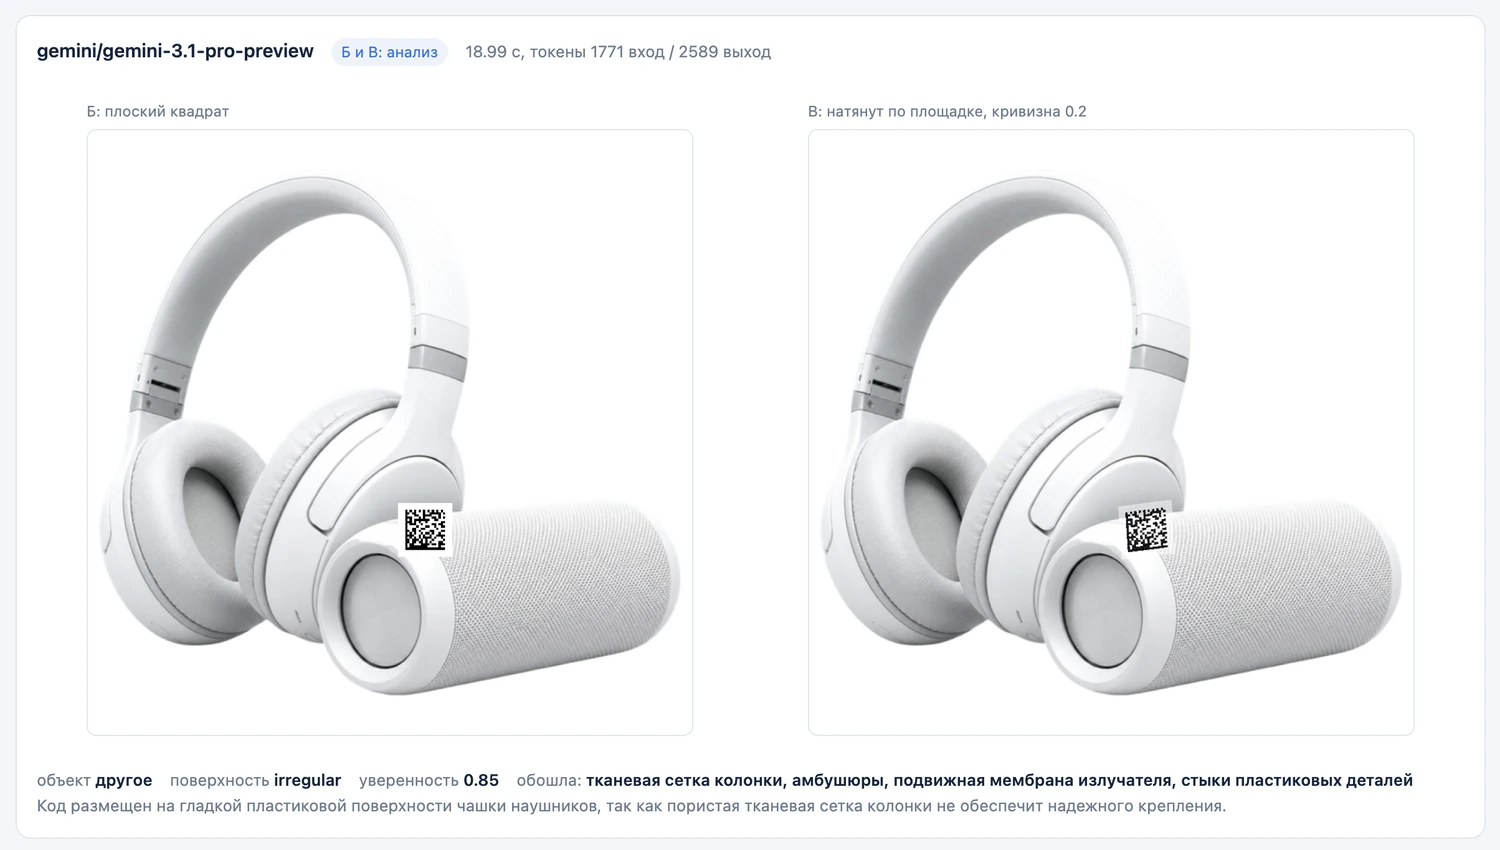
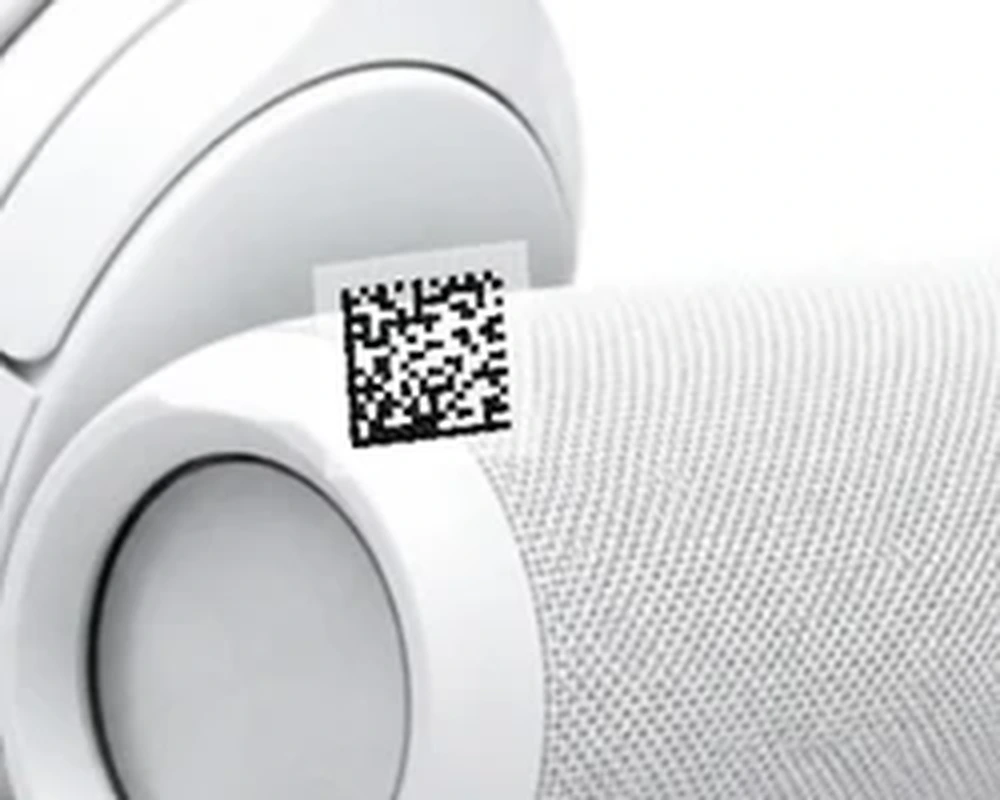
А код встал ровно на границе: левая половина на белом пластиковом ободке чашки, правая заехала на ту самую сетку, которую модель забраковала своими же словами. Слова верные, координаты подвели.
Оба кадра – из предварительных кругов, где через мой стенд шли и другие нейросети, не только те три, которые дошли до итогового сравнения. Имена моделей видны на самих кадрах, поэтому я их не скрываю: выдумала коробку deepseek-v4-pro, на сетку поставила код gemini-3.1-pro-preview.
Что из этого следует для заказчика. Демонстрация, где нейросеть бодро рассказывает, что она сделала, не доказывает ничего. Доказывает только замер: взяли три десятка реальных случаев, сравнили результат с тем, как сделал бы человек, посчитали долю попаданий.
Как я сравнивала нейросети: 18 прогонов на шести товарах
Сначала я оценивала прогоны так, как это, кажется, делает большинство: читала объяснения моделей. По ним выстроился внятный рейтинг с уверенным лидером.
Он продержался до первой сверки по картинкам. Модель, которая красивее всех объяснила, почему нельзя клеить на сетку, поставила код ровно на неё. А модель, чей выбор я записала в спорные, оказалась из тех немногих, кто попал кодом целиком на ровный пластик. Рейтинг перевернулся: сначала у отдельных прогонов, потом у итоговой таблицы. Средние баллы всех трёх моделей – в первой части.
Сравнивались шесть категорий товаров – радиоэлектроника, косметика, мягкая игрушка, тюбик, одежда, чай – на трёх нейросетях. Каждый запуск одного фото через одну модель я дальше называю прогоном; всего их вышло восемнадцать.
| Категория | Лучший результат | Типовая ошибка остальных |
|---|---|---|
| Радиоэлектроника | gpt-5.5 – торец колонки, 6/10 | код на стыке деталей и швах; подмена объекта в описании |
| Косметика | gpt-5.5 – поясок банки, 8/10 | код на завале цилиндра, мимо оси |
| Мягкая игрушка | luna – живот, 6/10 | код через шовное кольцо, на банте и ворсе |
| Тюбик | opus-5 – корпус, 7/10 | мелкий код у самого обреза |
| Одежда | ничья, у всех 4/10 | все три – на складке |
| Чай | luna – лицевая панель, 8/10 | вплотную к запайке и на сгибе гуссета |
Показательно распределение побед: самая дорогая модель серии выиграла одну категорию из шести, самая дешёвая – две. А в категории "одежда" не выиграл никто: все три положили код на складку футболки, ровный низ не нашла ни одна.
Что из этого следует для заказчика. Дорогая модель не значит подходящая. Какая справится с вашей задачей, показывает только прогон на ваших данных, а не позиция в чужих рейтингах.
Почему проверка тоже может ошибаться
Дальше самое неприятное и самое полезное: дважды на завышенных обещаниях была поймана не модель, а моя собственная проверка.
Первый раз – когда я решила, что предварительный отбор мест делает попадание кода на шов невозможным, и так и написала. Увеличенный кадр показал код ровно на переходе от гладкого кольца колонки к сетчатому корпусу. Мерка, на которую опирался отбор, оказалась грубой: она считала, насколько поверхность пёстрая в целом, и не отличала равномерную фактуру от одного стыка, рассекающего площадку пополам.
Второй раз – когда я научила программу отделять товар от фона по светлоте и назвала это защитой от промаха. Вопрос, который всё разрушил, звучал просто: а если программа примет за товар пустой фон? Именно так бы и случилось. Студийный фон ровнее любого товара, а белая упаковка на белом фоне от него по светлоте не отличается. Проверку пришлось переделать, и с честной оговоркой: если товар слился с фоном, программа пишет "попадание не проверено", а не гадает.
Общее в обоих случаях: проверка казалась объективной, потому что выдавала число. Но число – это ещё не измерение.
Сколько прогонов нужно, чтобы сравнить нейросети
К моменту, когда встал вопрос "а та ли модель выбрана", статистика выглядела солидно: около сорока версий программы, на каждой прогоны трёх моделей по нескольким фото, итого сотни запусков и шесть сравнительных таблиц. Полное ощущение измеренности.
По сути это были добросовестно собранные впечатления. Между версиями менялась сама программа: другие площадки, другой размер кода, другая обводка товара. Модель на двадцатой версии и она же на сороковой решали разные задачи, складывать их результаты в одну статистику нельзя.
Дело не в количестве прогонов, а в том, что плыли условия. Тридцать прогонов на одной и той же, никуда больше не правленной версии дают больше, чем сотни на сорока разных. И отдельная ловушка, в которую я попала: правки шли быстрее, чем замеры. Каждая новая версия обесценивала предыдущие прогоны, а соблазн сразу проверить её был сильнее, чем дисциплина сначала зафиксировать условия.
Как выбрать нейросеть и не переплатить за неё
Правильный порядок я взяла из области, где выбор модели давно поставлен на поток: сначала простое правило без всякого ИИ, потом кандидаты, потом доводка двух лучших и финальное сравнение на одном и том же наборе примеров.
| Метрика | Что означает |
|---|---|
| Точность выбора (главная) | доля прогонов, где выбор модели входит в размеченное человеком множество приемлемых площадок |
| Доля грубых ошибок (вес выше) | выбрана съёмная деталь, чужой предмет в кадре, шов |
| Доля честных отказов | модель отказалась выбирать и была права |
| Стоимость и скорость | токены и секунды из реальных прогонов |
| Согласие моделей между собой | вспомогательная: мерит сложность кадра, а не правоту |
Самый важный пункт здесь первый – правило без нейросети. В моей задаче оно звучало так: всегда бери первое место из тех, что программа посчитала самыми гладкими. Если модель не бьёт это правило по точности, вызывать её не нужно вообще – вместе с её стоимостью.
Это не теория. Представьте магазин, где покупает двое из ста посетителей. Программа, которая на всех отвечает "не купит", будет права в 98 случаях из 100 – и при этом бесполезна. Высокая точность сама по себе ничего не значит, пока не с чем сравнить.
Нужен ещё эталон – правильный ответ, с которым сравнивают: человек проходит по три десятка фотографий и отмечает, какие места под код приемлемы, а какие нет. Это примерно час работы, и без него сравнивать не с чем. И повторы: на одном и том же снимке нейросеть отвечает по-разному, поэтому нужно среднее по нескольким попыткам и размах между худшей и лучшей, а не одно красивое число.
Почему согласие трёх источников ничего не доказывает
Этот вывод я теперь применяю далеко за пределами задачи с кодами.
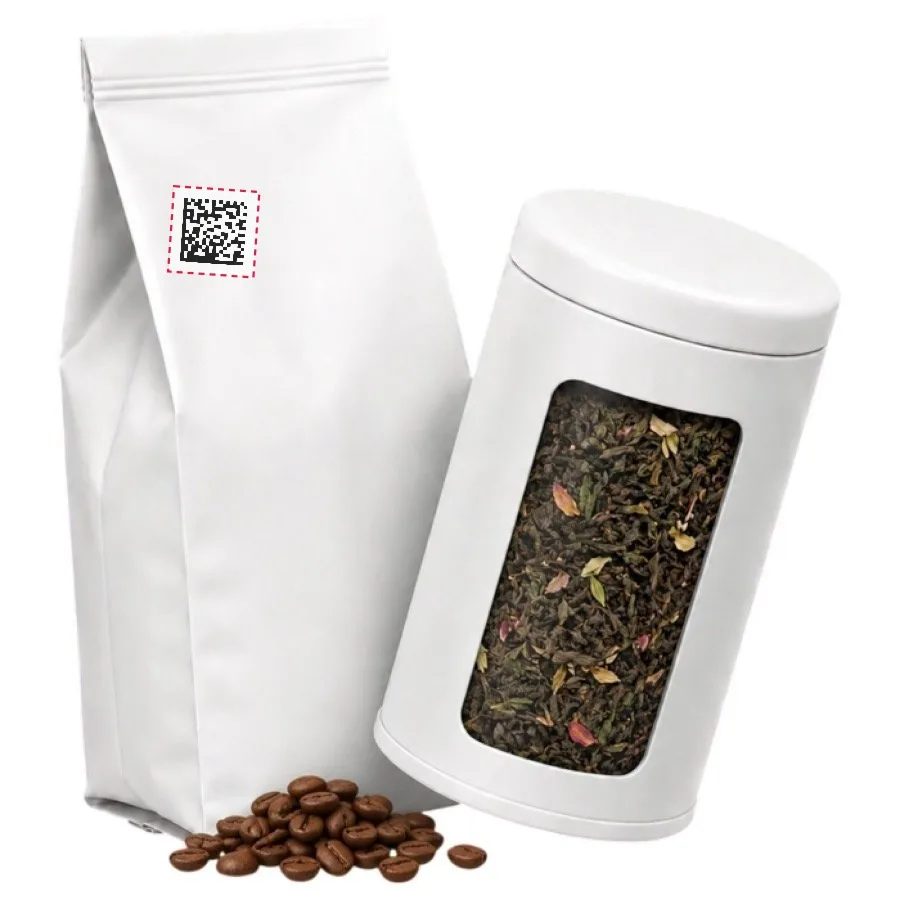
Код на пакете кофе повернулся не в ту сторону: края поверхности шли под углом около 70 градусов, а код встал почти вертикально. Первое объяснение – перепутан знак в формуле – не подтвердилось, формула была верной.
Настоящая причина сидела в голосовании. Угол поворота у меня считали несколько способов сразу, и три из них дружно дали одинаковый неверный ответ. Три способа, три голоса – выглядит как надёжное подтверждение. Только все три меряли одно и то же: общие очертания предмета в кадре. А единственный способ, который смотрел на линии самой поверхности, дал верный ответ и был перевешен большинством.
Три замера одной и той же величины – это не три независимых подтверждения, а один голос, повторённый трижды. То же самое происходит, когда задачу отдают сразу нескольким нейросетям и считают их согласие доказательством: модели учились на пересекающихся данных и часто ошибаются одинаково.
Тот же день дал ещё три разбора, где замер опроверг первое объяснение. "Модель ставит код только на лоб игрушки" оказалось дефектом моего перебора мест, "огромный код" – неверно выбранной категорией товара, "мутный код" – формулой, которая меряла резкость там, где её не бывает. Из четырёх претензий к нейросети три оказались претензиями к моему собственному коду, и без замера они были неотличимы.
Почему без отладочной картинки ошибку ищут вслепую
Почти каждая трудная ошибка в этой работе была трудной по одной причине: не было видно, что программа считает происходящим, и правки делались по следствиям.
Обводку товара я трижды чинила вслепую, пока не сделала отладочную картинку: красным закрашивается всё, что программа считает фоном. Один кадр объяснил то, что три правки объясняли неверно. Снаружи обводка была идеальной, а просвет под дугой наушников остался "товаром" – и место под код садилось ровно в него.
Отдельный сюжет: невидимой оказалась сама версия программы. Полтора часа мы разбирали дефекты, которых уже не существовало, потому что в браузере из памяти работал файл на семь правок старее, чем на сервере. С тех пор номер версии печатается прямо на странице, и любой разбор начинается со сверки этого номера.
Правило простое: картинку, показывающую, что программа думает о происходящем, надо делать сразу, а не после третьей неудачной правки. Час на неё окупился в тот же вечер.
Почему на рабочем сайте нейросеть работает иначе, чем на тесте
7 августа конфигуратор переехал со стенда на боевой сайт, и первая же претензия звучала знакомо: модель выбрала шов на животе игрушки, хотя на стенде выбирала лапу. То есть на боевом сайте она как будто поглупела.
Разбор по записям разложил всё иначе. На боевом сайте работал режим, где модель выбирает из мест, найденных моей программой, а на стенде тот же товар прогонялся в режиме, где модель называет место сама. Сравнивались не две версии модели, а два разных режима работы. Это уже третий случай в проекте, когда претензия к нейросети оказалась претензией к моему списку вариантов.
Второй урок – про доверие к собственным расчётам. Цену вызова у нового поставщика я сначала посчитала: взяла расход стендовых прогонов, умножила на новые тарифы, вышло 0,084 рубля. Замер по разнице баланса показал 0,048 рубля – расчёт был завышен почти вдвое. Арифметика по опубликованному тарифу выглядит как измерение, но им не является: округления, служебные расходы и особенности биллинга живут вне прайса.
Тот же вечер дал и обратный пример, когда замер подтвердил догадку и сэкономил деньги. Я предполагала, что у одной и той же модели бывают разные маршруты обслуживания и дешёвый может оказаться медленнее. Проверять это подряд – сначала пять дорогих вызовов, потом пять дешёвых – нечестно: сервис за это время успевает разгрузиться, и разница покажет загрузку, а не маршрут. Поэтому маршруты чередовались прогон за прогоном на одном и том же снимке. Время совпало до десятых долей секунды, а списание отличалось ровно вдвое.
Третий урок – про собственные приборы. Мой серверный счётчик расходов, который стережёт суточный бюджет, насчитал 0,069 рубля там, где поставщик списал 0,076. Расхождение около девяти процентов, и оно в опасную сторону: реальные траты выше тех, что видит защита. Свой счётчик надо время от времени сверять с чужим, иначе он незаметно превращается из измерения в оценку.
Что спросить у подрядчика, который делает ИИ-функцию
Пять вопросов, которые отличают замер от впечатления. Ответы на них у честного подрядчика есть сразу.
- На скольких случаях замерено и на какой версии? Нужна одна замороженная версия, а не "мы много гоняли".
- С чем сравнивали? Должен быть вариант без ИИ, самый простой. Если его нет, непонятно, за что вы платите.
- Кто размечал правильный ответ? Эталон делает человек, иначе сравнивать не с чем.
- Сколько раз повторяли один и тот же случай? На одном входе нейросеть отвечает по-разному, поэтому нужны среднее и разброс.
- Чем проверяли результат – глазами или измерением? "Выглядит хорошо" и "попало в допустимую зону в 26 случаях из 30" – разные утверждения.
Сколько всё это стоит в деньгах и как считать цену обращения к нейросети – в третьей части.
Когда это нужно вам
Всё перечисленное имеет смысл, когда нейросеть в вашем продукте принимает решения, которые видит клиент: выбирает, подсказывает, отвечает, проверяет. Тогда вопрос "работает ли она" перестаёт быть вопросом вкуса и становится вопросом замера – с эталоном, повторами и понятным сравнением с вариантом без ИИ.
Если такой процесс нужно поставить у вас – от стенда до метрик качества и контроля расходов, – напишите мне.
Частые вопросы
Можно ли оценивать качество ответа нейросети по её объяснению?
Нет. В нашем эксперименте модели подробно объясняли, что "обошли шов" или "не задели ткань", но при сверке с фактическим положением кода на изображении текст совпал с реальностью только в 4 прогонах из 18. Модель, красивее всех объяснившая запрет на тканевую сетку, поставила код ровно на неё. Оценивать нужно результат, а не рассказ о нём.
Значит ли высокая уверенность модели, что ответ правильный?
Нет. В наших прогонах уверенность 0,96 сопровождала галлюцинацию: модель подробно описала коробку, которой на фото не было. Уверенность – это часть ответа модели, а не внешняя оценка, и проверять её нужно так же, как остальные утверждения.
Сколько прогонов нужно, чтобы корректно сравнить модели?
Важно не количество, а фиксированные условия. Сотни прогонов на сорока версиях алгоритма несравнимы между собой: модель решала разные задачи. Достаточно порядка 30 прогонов на одной замороженной версии кода, с размеченным человеком эталоном приемлемых ответов и с повторами: модели недетерминированы, нужны среднее и разброс.
Что такое baseline при выборе LLM и зачем он нужен?
Baseline – это тривиальное правило без ИИ, с которым сравнивают модель. В нашей задаче: "всегда бери первую площадку по скору гладкости". Если модель не превосходит такое правило по точности, её вызов не нужен вообще – вместе со стоимостью и задержкой. Это аналог классической проверки на несбалансированных классах, где модель "никто не купит" даёт 98% точности.
Почему согласие нескольких методов или моделей не доказывает правильность ответа?
Потому что согласие значимо только при независимости источников. У нас три метода оценки угла дружно дали +4 градуса – и все три меряли одно и то же: очертания композиции. Верный ответ дал единственный метод, смотревший на линии поверхности, и его перевесили голосованием. Для ансамблей нейросетей это та же ловушка: модели, обученные на пересекающихся данных, – это один голос, а не три.
Модель на проде работает хуже, чем на тестовом стенде. Как понять причину?
Сначала убедиться, что сравниваются сопоставимые вещи. У нас претензия "на проде модель выбрала живот игрушки, а на стенде лапу" объяснилась не деградацией модели, а разными режимами: на проде она выбирала номер из площадок, найденных нашим кодом, и физически не могла назвать место, которого мы не предложили. Помогает архив разборов, где для каждого прогона записаны режим, версия кода и полный ответ модели – без него разбор превращается в догадки.
Материалы по теме
Что почитать дальше по этой теме
